
热线程要把活交给另一个线程,比如一行日志、一条行情、一个订单事件,不能用互斥锁。没人抢的时候加锁很便宜,问题出在有人抢的时候:抢输的一方会在内核里睡下,什么时候醒由调度器决定;拿着锁的如果是一个低优先级的后台线程,还会造成优先级反转。要避开的不是平均多出来的几十纳秒,而是一条又长又不受控制的延迟尾巴。
所以这里要的不是“快”,而是“有上界”,工具是无锁队列。整个设计立在一条规则上:每个共享变量只有一个写者,每一边只写自己的下标、只读对方的,两个核永远不抢着写同一个东西。热线程绑核、隔离(#1),碰的内存锁住、提前缺页(#3),release/acquire 和缓存行的代价(#2),这几篇的内容下面都默认已经知道。
1. SPSC 环形队列
1.1 两个下标加一个掩码
单生产者单消费者(SPSC)队列就是一个固定大小的槽数组,加两个只增不减的下标。生产者独占 write_idx,只有它写;消费者独占 read_idx。每一边都读对方的下标,生产者用它判断还有没有空位,消费者用它判断有没有数据,但从不去写它。每个变量只有一个写者,就没有什么需要加锁,也没有什么需要重试。
template <typename T>
class SpscQueue {
  std::vector<T> slots_;                       // 容量是 2 的幂
  size_t         mask_;                        // 容量 - 1

  alignas(64) std::atomic<size_t> write_idx_{0};   // 只有生产者写
  alignas(64) std::atomic<size_t> read_idx_{0};    // 只有消费者写

 public:
  explicit SpscQueue(size_t n) : slots_(round_up_pow2(n)), mask_(slots_.size() - 1) {}

  // ---- 生产者 ----
  T* try_claim() {                             // 第 1 步:往哪写?nullptr 表示满了
    const size_t w = write_idx_.load(std::memory_order_relaxed);   // 自己的下标
    const size_t r = read_idx_.load(std::memory_order_acquire);    // 对方的下标
    if (w - r == slots_.size()) return nullptr;
    return &slots_[w & mask_];
  }
  void publish() {                             // 第 2 步:让元素对消费者可见
    write_idx_.store(write_idx_.load(std::memory_order_relaxed) + 1,
                     std::memory_order_release);
  }

  // ---- 消费者 ----
  T* try_peek() {                              // nullptr 表示空的
    const size_t r = read_idx_.load(std::memory_order_relaxed);    // 自己的
    const size_t w = write_idx_.load(std::memory_order_acquire);   // 对方的
    if (r == w) return nullptr;
    return &slots_[r & mask_];
  }
  void release() {                             // 读完了,把槽还回去
    read_idx_.store(read_idx_.load(std::memory_order_relaxed) + 1,
                    std::memory_order_release);
  }
};
这段代码有三处设计:
- 槽的位置用
idx & mask_算,所以容量取 2 的幂:容量是 2 的幂时,mask_ = 容量 - 1的低位全是 1,idx & mask_就等于idx % 容量。容量是运行时才知道的值,编译器没法把%换成位运算,所以构造函数把容量向上取整到 2 的幂,热路径上就只是一次按位与,而不是一次除法。下标只增不减,判满用w - r == 容量,不用担心回绕。 - 生产者分两步:先拿到槽的指针,再发布:
try_claim返回槽的地址,元素直接在槽里构造,只写一次;push(const T&)的写法要先在别处构造好再拷进来。发布单独一步,因为那是消费者唯一可以看到这个元素的时刻。 - 读自己的下标用 relaxed,读对方的用 acquire,写自己的用 release:自己的下标只有自己写,一个线程总能看到自己之前的写,所以 relaxed 就够。对方的下标才是跨核传信息的:生产者 release 写
write_idx_,消费者 acquire 读到新下标时,就能看到槽里的内容;消费者 release 写read_idx_,生产者看到槽空出来时,消费者一定已经读完了它。x86 上这几次 release 写编出来都是普通的mov,ARM 上是stlr。
如果判满用的是取过掩码的下标而不是只增不减的下标,要小心运算符优先级:(w + 1) & mask == r & mask 里 == 比 & 先算,实际是 ((w + 1) & (mask == r)) & mask,几乎永远是假,生产者会覆盖还没读的数据。要么给两边都加括号,要么像上面那样用不回绕的下标相减。
1.2 元素个数用两个下标相减,不另设计数器
很容易想再加一个原子的元素计数,生产者发布后加一,消费者释放后减一,size() 就是读一次:
std::atomic<size_t> count_{0};
// 生产者,发布之后:   count_.fetch_add(1, std::memory_order_release);
// 消费者,释放之后:   count_.fetch_sub(1, std::memory_order_release);
这个计数器两个核都要写,正好破坏了“一个变量一个写者”。 fetch_add、fetch_sub 是读改写,要先拿到这一行的独占权,于是每次入队都把这一行从消费者那里抢过来,每次出队又抢回去。这是真共享,不是伪共享:两个核确实在改同一个变量,把它填充到单独一条缓存行上也没用。
元素个数其实早就有了,就是 write_idx - read_idx。算它只要两次读,读只需要这一行处于共享状态,不用抢独占权:
size_t size_approx() const {
  const size_t r = read_idx_.load(std::memory_order_acquire);    // 先读落后的那个
  const size_t w = write_idx_.load(std::memory_order_acquire);   // 再读领先的那个
  return w - r;
}
用的时候记住两点:
- 结果是近似值:两次读发生在略有先后的两个时刻,拼出来的不是同一瞬间的状态。看“大概积压了多少”没问题,需要精确值的判断不能靠它。两次读之间两边都可能往前走,结果甚至可能超过容量,在意的话要夹一下。
- 先读
r,再读w:任何时刻都有w >= r,w又只增不减,后读到的w不会比先读到的r那一刻的w小,差值就不会是负数。反过来读,一个旁观的线程(比如监控循环)可能拿到两边都往前走之前的w和之后的r,w - r变成负数,对无符号数来说就是一个巨大的值。第一次读用 acquire,是为了不让第二次读被重排到它前面。生产者或消费者自己调用时碰不到这个问题,因为它自己的下标不会在调用中途变化;这条规则是给任何线程都可能调用的size()准备的。
2. 把剩下的跨核流量再压一压
2.1 缓存一份对方的下标:只会往安全的方向过期
try_claim() 每次都要 acquire 读一次 read_idx_,这是消费者写的变量。队列离满还远的时候,这次读其实白读了,而且不便宜:消费者每推进一次下标,生产者下一次读都要跨核去取更新过的那一行。消费者的 try_peek() 读 write_idx_ 也是一样。
修法是每一边保留一份对方下标的本地副本,用它做判断,只有副本说“满了”或“空了”时,才真的去读一次对方的下标、刷新副本、再判断一次:
alignas(64) std::atomic<size_t> write_idx_{0};
            size_t              cached_read_idx_ = 0;    // 生产者私有,和生产者自己的下标放在同一行
alignas(64) std::atomic<size_t> read_idx_{0};
            size_t              cached_write_idx_ = 0;   // 消费者私有

T* try_claim() {
  const size_t w = write_idx_.load(std::memory_order_relaxed);
  if (w - cached_read_idx_ == slots_.size()) {                       // 看起来满了,副本可能过期
    cached_read_idx_ = read_idx_.load(std::memory_order_acquire);    // 付一次跨核读
    if (w - cached_read_idx_ == slots_.size()) return nullptr;       // 真的满了
  }
  return &slots_[w & mask_];
}

T* try_peek() {
  const size_t r = read_idx_.load(std::memory_order_relaxed);
  if (r == cached_write_idx_) {                                      // 看起来空了,刷新
    cached_write_idx_ = write_idx_.load(std::memory_order_acquire);
    if (r == cached_write_idx_) return nullptr;                      // 真的空了
  }
  return &slots_[r & mask_];
}
过期的副本只会让判断偏保守,不会出错。 消费者的下标只往前走,生产者手里的副本永远小于等于真实值,按副本算出来的空位只会偏少:它可能在其实还有空位时说“满了”,这时代码会刷新一次、发现真相;但它不可能在没有空位时说“还有”。消费者的副本也一样,可能太早说“空了”,不可能在没有数据时说“有”。
还有一个好处:消费者真去刷新时,往往会发现已经到了很多个元素,可以一口气处理完,再去碰生产者的那一行。跨核读从每个元素一次,变成了每一批一次。
2.2 双重映射:让回绕处不用拆成两次拷贝
字节环形缓冲区或变长记录的环有一个别扭的地方:一次写从末尾附近开始,会越过末尾。通常要拆成两次拷贝,一次拷到末尾,一次从开头接着拷,再加一个分支判断什么时候要拆。
有一个办法能去掉这道接缝:把同一块物理内存映射到两段相邻的虚拟地址上,缓冲区看起来有两倍长,后一半是前一半的镜像。越过前一半末尾的写,直接写进后一半,落在的正是回绕后该在的位置,一次 memcpy,没有分支。在 Linux 上分三步:
void* base = mmap(nullptr, 2 * N, PROT_NONE, MAP_PRIVATE | MAP_ANONYMOUS, -1, 0);      // 只占下 2N 的地址
int   fd   = memfd_create("ring", 0);                                                  // 一个内存里的“文件”
ftruncate(fd, N);                                                                      // 长 N 字节
mmap(base,                          N, PROT_READ | PROT_WRITE, MAP_SHARED | MAP_FIXED, fd, 0);   // 第一个视图
mmap(static_cast<char*>(base) + N,  N, PROT_READ | PROT_WRITE, MAP_SHARED | MAP_FIXED, fd, 0);   // 第二个视图:同样的页
- 用
PROT_NONE占下2N字节的地址空间,只要地址,不要内存。 - 用
memfd_create建一个内存里的文件,ftruncate设成N字节。 - 把这个文件分别映射到前一半和后一半,都用
MAP_SHARED | MAP_FIXED。
两个视图背后是同样的物理页,所以 buf[i] 和 buf[i + N] 是同一个字节。
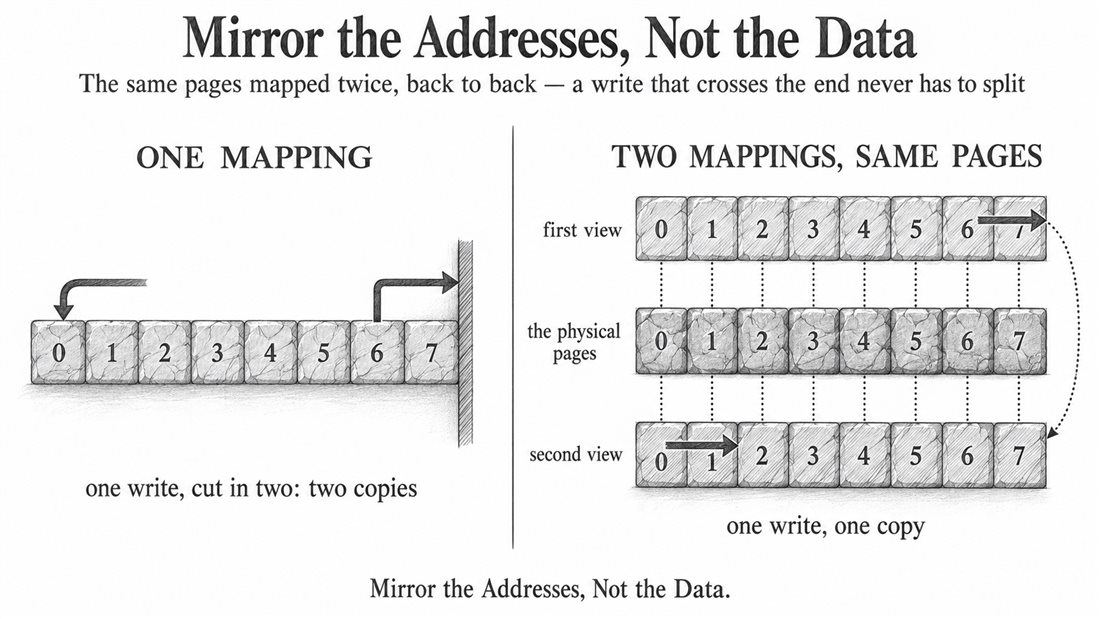
- 必须用文件描述符,两次匿名映射做不到:每个
MAP_ANONYMOUS映射都拿到自己全新的页,第二个映射没有东西可以指向。两段地址要共享页,得有一个两边都能引用的对象,这里是 fd,System V 共享内存段也行。 - 全部在构造时做完:占地址、建 fd、两次映射都只做一次,之后每次入队出队都是普通的内存访问,没有系统调用。和 #3 一样,这些页也应该提前缺页、锁住。
- 代价和适用范围:
N必须是页大小的倍数;中途失败要把已经做的munmap、close掉;第二个视图多占页表项和 TLB。1.1 的队列用不上它:槽是固定大小的,一个元素不会跨过末尾。它适合字节流、变长记录、一次读写好几个元素的场景,这时拷贝本身是大头,跨过末尾又很常见。
3. 在队列上搭一个日志器
3.1 热线程只填槽,后台线程负责写文件
日志是这种队列最典型的用户。格式化、文件 I/O、write 系统调用都很慢,应该放在没人等的地方做:热线程只把要记的东西填进队列槽,一个后台线程负责把队列排空、写进文件。
队列的槽是固定大小的,所以槽里放一个带类型标签的 union,空间要能放下可能记录的最大东西:
enum class Tag : uint8_t { Char, Int, Long, Double, Text /* … */ };

struct LogElement {
  Tag tag;
  union {
    char c;  int i;  long l;  double d;  /* …其他数值类型… */
    char s[256];                          // 决定每个槽大小的就是这个成员
  } u;
};   // x86-64 上 264 字节:标签补齐到 8,再加 256 字节
char s[256] 决定了每个槽的大小:一个只装了一个 char 的元素,照样占 264 字节。800 万个槽大约 2 GiB,故意开得很大,因为后台线程慢,突发时一定会落后。
后台线程是一个循环,排空、刷文件、睡一会儿:
while (running_) {
  while (LogElement* e = queue_.try_peek()) {
    write_to_file(*e);                  // 按 e->tag 分情况处理
    queue_.release();
  }
  file_.flush();
  std::this_thread::sleep_for(std::chrono::milliseconds(10));
}
睡 10 ms 是一个选择:这个线程对延迟不敏感,把核让出去比空转好,代价是日志最多晚 10 ms 落盘,队列要装下这段时间里产生的全部内容。SPSC 还带来两条规则:
- 一个日志器只服务一个生产线程:第二个生产者会打破“每个下标一个写者”,所以要么每个线程一个日志器,要么每个线程一个队列。
- 关闭时先排空队列,再停后台线程,最后关文件:先停后台线程的话,还在队列里的日志就悄悄丢了。
3.2 按文本段推:一行日志只占 5 个槽
生产者的 log() 沿着格式串走,把一行日志拆成几个元素推进队列。推入的单位是一段文本,不是一个字符:两个 % 占位符之间的字面文本攒成一个 Text 元素,每个占位符推一个值。log("Order Executed, id=%, price=%\n", id, price) 一共推 5 次:三段文本、两个值。
图:两行记录的是同一行日志。队列、内存序、后台线程都没变,变的只是每次调用推入的单位:30 次发布变成了 5 次。
单位要大,是因为每个槽不管装多少都占 264 字节(3.1),槽数就是成本。同一行日志,两种推法比一比:
| 推入单位 | 一行占几个槽 | 一次调用写多少 | 800 万个槽能装几行 |
|---|---|---|---|
| 每个字符一个槽 | 30 | 约 7.7 KiB,124 条缓存行 | 约 27 万 |
| 每段文本一个槽 | 5 | 约 1.3 KiB | 约 160 万 |
- 热路径按槽付钱:每个槽一次拷贝、一次 release 写,30 个槽就是 30 次。
- 写得越多,L1 越脏:L1 数据缓存一般是 32–48 KB,一次调用写 7.7 KiB 就弄脏它的六分之一到四分之一,紧接着运行的代码要把自己的数据重新读回来;1.3 KiB 只占 3%–4%。
- 能缓冲的行数差 6 倍:同样 800 万个槽,后台线程慢一阵,按文本段推的队列也不容易写满。
一段文本超过 255 个字符,就拆成几个槽。只改生产者的 log(),后台线程本来就会写 Text 槽:
LogElement* claim() {                       // 队列满了怎么办,在这里决定
  LogElement* s;
  while ((s = queue_.try_claim()) == nullptr) { /* 空转等待,或者记一次丢弃、放弃这条记录 */ }
  return s;
}

void push_text(const char* p, size_t n) {
  while (n > 0) {
    const size_t k = std::min<size_t>(n, 255);         // 给结尾的 '\0' 留位置
    LogElement* slot = claim();
    slot->tag = Tag::Text;
    std::memcpy(slot->u.s, p, k);
    slot->u.s[k] = '\0';
    queue_.publish();
    p += k;  n -= k;
  }
}

template <typename T, typename... Rest>
void log(const char* fmt, const T& value, const Rest&... rest) {
  const char* run = fmt;                                // 当前文本段的起点
  for (; *fmt; ++fmt) {
    if (*fmt == '%') {
      push_text(run, static_cast<size_t>(fmt - run));   // 占位符之前的文本一次推完
      push(value);
      log(fmt + 1, rest...);
      return;
    }
  }
}
void log(const char* fmt) { push_text(fmt, std::strlen(fmt)); }
这是一个草图,没有处理 %% 转义和参数个数不对的情况。
3.3 更进一步:只推格式串的指针,或者在编译期解析
两个更大的改动,都在继续减少每次调用推入的槽数:
- 只推格式串的指针,由后台线程格式化:字符串字面量有静态存储期、不会被修改,地址在整个运行期间都有效,所以热路径只需要推一个 8 字节指针加参数值。这改的是协议:后台线程要解析格式串、取对个数的参数槽;而队列一次只发布一个槽,它可能看到指针到了、参数还没到,所以要一次占好几个槽一起发布,或者改成变长记录。
- 在编译期解析格式串:把一条日志里所有静态的东西(格式串、参数类型)在编译期换成一个小 ID,运行时只记 ID 和原始参数值,转成文本的工作留到离线去做。NanoLog 就是这样做的,它的 README 报告每次调用中位数约 7 ns(这是它自己的测量,本文没有复现)。Quill 走另一条路:热线程把参数编码进自己的队列,后台线程负责格式化和 I/O,队列满了阻塞还是丢弃可以配置,并统计各自发生了多少次。
按指针传只适用于活满整个运行期、又永远不变的东西,参数没有这个性质:
void on_fill(const Fill& f) {
  std::string sym = f.symbol();
  logger.log("symbol=%\n", sym);     // 假设只把 sym 的字符指针放进队列
}                                    // sym 在这里就销毁了,后台线程要过一会儿才来读
后台线程最多要等十几毫秒才来读,那时 sym 早已销毁,c_str() 指针指向的内存已经无效。所以参数要在生产者线程里、趁它还拥有这些值的时候拷进队列。
这几种改法其实是同一个思路:一次 log 调用的代价等于每次调用推入的槽数乘以每个槽的代价,每一个真正有效的改法都在减少前一个因子,而不是去打磨后一个。
4. lock-free 承诺的是进展,不是速度
4.1 四级进展保证
“lock-free”常被用得很随意。按“别的线程变慢、被挂起或者死掉时会怎样”,进展保证从弱到强分四级:
| 保证 | 承诺了什么 | 典型形状 |
|---|---|---|
| 阻塞 | 什么都不承诺:另一个线程被换下去,你可能被无限期卡住 | 一把锁;空转等另一个线程的标志 |
| 无障碍(obstruction-free) | 别人都停下来时,你能在有限步内完成;有竞争时可能活锁 | 多半只在文献里出现 |
| 无锁(lock-free) | 整个系统总在前进:总有某个线程在有限步内完成,但某个线程可能一直输 | CAS 重试循环 |
| 无等待(wait-free) | 每个线程都在自己的有限步内完成,不管别人在做什么 | 固定几步,没有重试循环 |
lock-free 保证的是总有人在前进,wait-free 保证的是每个人都在前进。 所以 lock-free 不等于从不等待:卡在 CAS 循环里的线程就在等,只是它每次重试失败,都意味着别人成功了一次。
4.2 SPSC 队列属于哪一级
| 操作 | 为什么 | 保证 |
|---|---|---|
try_claim + publish(满了返回 nullptr) | 固定几次读写,没有循环,完成与否不取决于消费者 | wait-free |
| 空转直到有空槽的生产者 | 循环能不能退出取决于另一个线程 | 阻塞 |
try_peek + release(空了返回 nullptr) | 和生产者一侧同样的形状 | wait-free |
共享计数器上的 fetch_add / fetch_sub | x86 上是一条 lock xadd;没有 LSE 扩展的 ARM(ARMv8.1 之前)上编译成 load-exclusive / store-exclusive 重试循环 | x86 上 wait-free,老 ARM 上是 lock-free |
由此得出四点:
- “SPSC 是 wait-free”说的是接口,不是数据结构:它之所以做得到,是把满了、空了怎么办推给了调用者,
try_失败就返回,由调用者决定丢弃、重试还是阻塞。空转等空位的版本把“阻塞”写死在了里面。去掉 1.2 的共享计数器以后,热路径上只剩普通的读和写,这个说法也就不依赖硬件怎么实现原子读改写了。 - “消费者挂了也伤不到生产者”只在队列还有空位时成立:环是有界的,一满,生产者只能丢掉这一项或者等,而一等,消费者的状况又回到了你的关键路径上。缓冲区越大,离满越远,但满的那一刻总会来。所以成熟的日志库把“满了阻塞还是丢弃”做成配置,3.2 里每次调用占几个槽也就不只是速度问题,还是可靠性问题。
- 有限步不等于有限时间:wait-free 只限制你执行的步数,管不了操作系统在中途抢占你、缺页、缓存未命中。可预测的延迟要三层一起做到:算法上不依赖别的线程,操作系统上绑核、隔离、实时优先级(#1),内存和硬件上提前缺页、锁页(#3)、注意缓存行(#2)、热路径上不做系统调用。
- wait-free 不会自动更快:竞争不多时,普通的 CAS 循环通常第一次就成功,做的事比一个为了保证上界而带着整套机制的实现还少。wait-free 买到的是上界,目标是 P99.9 这类尾延迟时才值得。用 CAS 抢槽的多生产者队列是典型的“lock-free 但不是 wait-free”,而且常常就是对的选择。
5. Micro-Batching:按积压量决定批大小
5.1 有多少拿多少,绝不等着凑满一批
批处理能摊薄每条消息的固定开销,一次唤醒、一次下游调用就能处理很多条,但为了凑满一批而等待的每条消息,都要多付延迟。固定批大小两头都不对:忙的时候太小,闲的时候太慢。办法是让当前积压了多少来决定这一批拿多少:
批大小:按积压量选
- 积压不超过 10 条:不忙,优先延迟,一批 1 条。
- 积压 11–100 条:中等,一批最多 100 条。
- 积压超过 100 条:已经落后,优先吞吐,一批最多 1000 条。
size_t pick_batch(size_t backlog) {
  if (backlog <= 10)  return 1;
  if (backlog <= 100) return 100;
  return 1000;
}

size_t drain(Queue& q, std::vector<Msg>& out, size_t target) {
  size_t n = 0;
  Msg m;
  while (n < target && q.try_pop(m)) { out.push_back(m); ++n; }   // 绝不等着凑满一批
  return n;
}
关键在循环条件:drain 最多拿 target 条,队列一空就停,从不等着凑满。没有积压时,一批就是一条,不增加任何延迟;只有消息已经堆起来时,批才变大,而这些消息反正本来就要等。批大小不需要定时器,就跟着负载走。
5.2 积压量从队列读,不另设计数器
很容易想用一个计数器记积压:入队时 fetch_add(1),每批之后 fetch_sub(batch_size)。这又是 1.2 那个两个核抢着写的变量,而且它还不准:计数是在入队之后才加的,一个快的消费者可能在生产者加一之前就把消息取走、先减了,对无符号计数器来说,值会短暂地变成一个巨大的数,恰好这时读的人会以为积压了很多。
所以直接问队列。代价体现在类型上:一个通用的批处理器只认识 try_pop,看不到队列的下标,所以要求队列类型提供一个 O(1) 的近似大小:
template <typename Q, typename Msg>
concept BatchSource = requires(Q q, Msg& m) {
  { q.try_pop(m) }   -> std::convertible_to<bool>;
  { q.size_approx() } -> std::convertible_to<size_t>;
};
近似值就够了:它只用来在三档里选一档,差几条消息不会改变结果。
应用
1.2 节那个两个核抢着写的计数器,在实际优化里对应“B7 共享统计计数器”这张卡片:在 perf 里看到什么、怎么改、怎么验证。
- 信号:热路径上有
lock add/inc/xadd,没有 cmpxchg 重试循环;c2c 显示同一偏移被很多 CPU 写(真共享);1 核不显眼,多核才冒出来。- 原因:每次原子加都要独占缓存行,这一行在核之间来回传,每次接近内存延迟(约 100–300 ns)。改用 relaxed 内存序也没用,硬件照样要独占。
- 修法按优先级三选一:
- 自增在一个函数的循环里、热点不超过 2 处:本地变量攒一批,到批量或函数退出时用 relaxed 原子加一次。纯计算循环直接在末尾加一次。
- 自增散在多处:按 CPU 号分桶。64 字节对齐的统计结构体数组,下标用
sched_getcpu() & 63;所有计数器放进同一个结构体,只调一次sched_getcpu;读的时候把各桶加起来。- 共享库不方便持有全局数组:用
__thread线程局部变量,线程退出或定期刷到全局。- 已经分桶了还在抢:查是不是刷新太频繁,比如每个请求刷一次,拉长间隔。
- 验证:总数在任意时刻只是近似值,要确认业务能接受;
lock指令从热路径消失;c2c 上该行 HITM 下降。- 原理:一次写的价钱从哪来,见 MESI 专题第 5 节;计数器按线程分片、事后合并,见 MESI 专题第 6 节;两个核都写的那个计数器,见 #4 1.2。