
malloc 和 free 并不慢。在一个紧循环里调一千次,平均耗时看起来完全没问题。HFT 代码和它们的矛盾不在平均值,而在尾部,而尾部取决于你控制不了的状态。glibc 为了避免锁竞争,给每个线程分 arena,可线程数一旦超过 arena 数,两个线程就开始抢同一个 arena 的锁。当前 arena 满足不了的请求,可能意味着一次新的 brk 或 mmap 系统调用进内核。释放的内存被分进按大小划分的 bin 里,要遍历、可能还要合并,这要花多久,取决于这个堆之前经历过的全部碎片化历史。这些代价没有一个是固定的,全都取决于“这个进程到目前为止干过什么”——而这恰恰是热路径问不起的问题。
这篇里的一切,都是同一个修法的变奏:找出那个代价取决于首次访问、竞争或碎片化的操作,把它挪到程序生命里你不在乎它花多久的那个时刻——通常是启动时。第 1 节挪走分配本身。第 2 节挪走内核的两个决定:你的页能不能离开内存,以及——不那么显然的——它们到底有没有物理内存撑着。第 3、4 节把这一招推广到任意 STL 容器,并在“灵活性的账该在哪里付”上分道扬镳:编译期,还是运行时。第 1、3 节末尾各给一份能直接用的参考实现,第 5 节讲几个线程同时从池里分配时的无锁版本和 ABA。
1. 对象池:预先分好一批同类对象的槽,用时取、用完还
对象池:启动时给一种类型 T 一次分好固定数量的槽,热路径上分配就是取一个空槽,释放就是还回去,不再调 malloc。用在订单、行情消息这类数量有上限、反复创建和销毁的对象上。
1.1 扫描找空槽:最坏要扫完整个池
关键在“找下一个空槽”这一步:它必须每次都是同样的几条指令,和这个池之前被怎么用过无关。 最直接的写法是每个槽带一个“空不空”的标记,分配完以后往后扫,找到下一个空槽备用。
struct ObjectBlock {
  T    object_;
  bool is_free_ = true;
};
std::vector<ObjectBlock> store_;
std::size_t next_free_index_ = 0;   // 下一次分配用的槽

T* allocate() {
  ObjectBlock& b = store_[next_free_index_];
  b.is_free_ = false;               // 在 b.object_ 上原地构造,略
  // 为下一次找空槽:往后扫,到尾部绕回开头(池满的处理略)
  std::size_t i = next_free_index_;
  do {
    i = (i + 1) % store_.size();
  } while (!store_[i].is_free_ && i != next_free_index_);
  next_free_index_ = i;
  return &b.object_;
}
扫多远,取决于空槽在池里怎么分布:
- 对象按分配的顺序释放(先进先出):当前位置后面紧挨着就是空槽,扫一格就停。
- 对象持有的时间长短不一:空槽散落在池里,一次扫描可能走过大半个池,最坏 O(n)。
扫多久取决于这个池之前被怎么用过,这和 malloc 的毛病是同一种:耗时取决于历史,尾部延迟没法预测。进内核的系统调用是省掉了,不确定性还在。
1.2 空闲链表:下一个空槽一直记在链表头
修法是不去找:把所有空槽串成一条链表,分配从链表头取,释放放回链表头。“下一个空槽是哪个”一直记在 head_ 里,要用的时候直接拿。
T*           objects_;     // capacity 个槽,指向一块还没构造对象的内存
std::size_t* free_list_;   // free_list_[i]:槽 i 空闲时,链表里排在它后面的槽
std::size_t  head_;        // 第一个空闲槽,kInvalid 表示池用完了
static constexpr std::size_t kInvalid = static_cast<std::size_t>(-1);

T* allocate() {
  if (head_ == kInvalid) return nullptr;
  std::size_t i = head_;
  head_ = free_list_[i];                // 链表头移到下一个空槽
  return ::new (&objects_[i]) T();
}

void deallocate(T* p) {
  std::size_t i = static_cast<std::size_t>(p - objects_);
  p->~T();
  free_list_[i] = head_;                // 这个槽接到链表最前面
  head_ = i;
}
链表用数组下标串起来,不用指针:free_list_[i] 存的是下一个空槽的下标。拿 4 个槽走一遍:
| 操作 | 拿到或还回 | head_ | 空闲链表 |
|---|---|---|---|
| 启动 | 0 | 0 → 1 → 2 → 3 | |
allocate() | 槽 0 | 1 | 1 → 2 → 3 |
allocate() | 槽 1 | 2 | 2 → 3 |
deallocate(槽 0) | 槽 0 | 0 | 0 → 2 → 3 |
allocate() | 槽 0 | 2 | 2 → 3 |
分配和释放都是一次读、一次写,和池里有多少空槽、空槽在哪都无关。 链表是后进先出的,还有一个附带的好处:刚还回来的槽最先被再分出去,它多半还在缓存里。
1.3 下一个空槽的下标存在哪:单独数组、同一个槽、还是对象自己的内存
1.2 的 free_list_ 是和 objects_ 并列的另一个数组,T 不知道自己被串在链表里,这叫非侵入式。下标还可以放在别的地方,三种放法各有代价:
| 下标存在哪 | 一次分配碰几条缓存行 | 额外内存 | 代价 |
|---|---|---|---|
| 单独的数组(1.2) | 两条:free_list_[i] 和 objects_[i] 不在一起 | 每槽 8 字节 | 每次分配多一次缓存未命中的机会 |
| 和对象放在同一个槽里(1.4) | T 不大时一条 | 每槽 8 字节 | 无 |
对象自己的内存,即侵入式(union) | 一条 | 0 | 要求 sizeof(T) ≥ 8;对象释放后又被误写(use-after-free),会直接改坏链表,很难查 |
侵入式能成立,是因为空闲的槽里没有对象:这块内存本来就闲着,正好拿来存“下一个空槽”的下标;分配时先读出下标,再在同一个地址上构造 T,把它覆盖掉。
下标放哪:默认放进同一个槽
- 一般情况:和对象放在同一个槽里(1.4 的写法),一次分配只碰一条缓存行,代码也清楚。
- 槽很多、内存紧,
T又不小于 8 字节:用侵入式,每个槽省 8 字节。- 对象必须紧密排成一个
T数组(比如要按数组顺序遍历全部对象):只能用单独的数组。
1.4 参考实现:一个能直接用的对象池
下面这个池把空闲链表和后面两节的启动处理(第 2 节锁页、3.2 预先缺页)放在一起:
- 启动时一次拿到全部内存,锁住并缺完页:
aligned_alloc一次分配capacity个槽,mlock锁住,memset把每一页写一遍(第 2 节、3.2)。 - 空闲槽串成一条链表,分配和释放都只动链表头:
free_head_是第一个空闲槽的下标,每个空闲槽的next_free记着下一个。分配时取下链表头,释放时把槽放回链表头(1.2)。 - “下一个空闲槽”和对象放在同一个槽里:就是 1.3 表里的第二种。
next_free就在Slot里,分配时读next_free和接着构造T碰的是同一个槽,通常是同一条缓存行。
template <typename T>
class ObjectPool {
  struct Slot {
    alignas(T) unsigned char storage[sizeof(T)];  // 构造之后 T 就在这里
    std::size_t next_free;                        // 空闲时:下一个空闲槽的下标
  };
  static constexpr std::size_t kInvalid = static_cast<std::size_t>(-1);

  Slot* slots_;
  std::size_t capacity_;
  std::size_t free_head_;                         // 第一个空闲槽的下标

 public:
  explicit ObjectPool(std::size_t capacity)
      : capacity_(capacity), free_head_(capacity ? 0 : kInvalid) {
    std::size_t bytes = sizeof(Slot) * capacity_;
    slots_ = static_cast<Slot*>(std::aligned_alloc(alignof(Slot), bytes));
    if (!slots_) throw std::bad_alloc{};
    if (mlock(slots_, bytes) != 0) {
      // 没有 CAP_IPC_LOCK 或超过 RLIMIT_MEMLOCK:记一条日志,下面的 memset 照样提前缺完页
    }
    std::memset(slots_, 0, bytes);
    for (std::size_t i = 0; i < capacity_; ++i)
      slots_[i].next_free = (i + 1 < capacity_) ? i + 1 : kInvalid;
  }

  ~ObjectPool() {
    munlock(slots_, sizeof(Slot) * capacity_);
    std::free(slots_);
  }

  ObjectPool(const ObjectPool&) = delete;
  ObjectPool& operator=(const ObjectPool&) = delete;

  template <typename... Args>
  T* allocate(Args&&... args) {
    if (free_head_ == kInvalid) return nullptr;   // 池用完了:热路径上不抛异常
    Slot& slot = slots_[free_head_];
    free_head_ = slot.next_free;                  // 取下链表头
    return ::new (slot.storage) T(std::forward<Args>(args)...);
  }

  void deallocate(T* obj) {
    obj->~T();
    auto* slot = reinterpret_cast<Slot*>(
        reinterpret_cast<unsigned char*>(obj) - offsetof(Slot, storage));
    slot->next_free = free_head_;                 // 放回链表头
    free_head_ = static_cast<std::size_t>(slot - slots_);
  }
};
池用完时 allocate 返回 nullptr,不抛异常:热路径上由调用方决定是走慢路径还是丢掉这条消息。std::aligned_alloc 要求字节数是对齐值的倍数,sizeof(Slot) 本来就是 alignof(Slot) 的倍数,所以这里自然满足。
2. 锁页:拿到的内存不再还给内核
对象池让热路径不再向分配器要内存,可已经拿到的内存,内核还会动它:页可能被换出到磁盘,整块映射也可能被拆掉还回内核。下一次访问它,就要缺页、甚至读盘,热路径在某一次访问上突然慢几个数量级。这一节讲怎么把拿到的内存一直留住。
2.1 mlockall 加三个 mallopt:锁住页,也不让 glibc 把页还回去
mlockall(MCL_CURRENT | MCL_FUTURE):这个进程现在和以后映射的每一页都常驻内存,不会被换出。MCL_FUTURE 还让以后新映射的页在映射时就一次缺完、锁住。
它挡不住 glibc 自己把页还给内核。 锁跟着映射走,munmap 不是给页解锁,而是把整个映射拆掉,锁也跟着没了。glibc 正会这么做:大于 M_MMAP_THRESHOLD(默认 128 KB)的分配单独 mmap 一块,free 时马上 munmap。热路径上每次这样的分配和释放,都是一对系统调用,再加上缺页(MCL_FUTURE 下,新映射的页在 mmap 里一次缺完)。
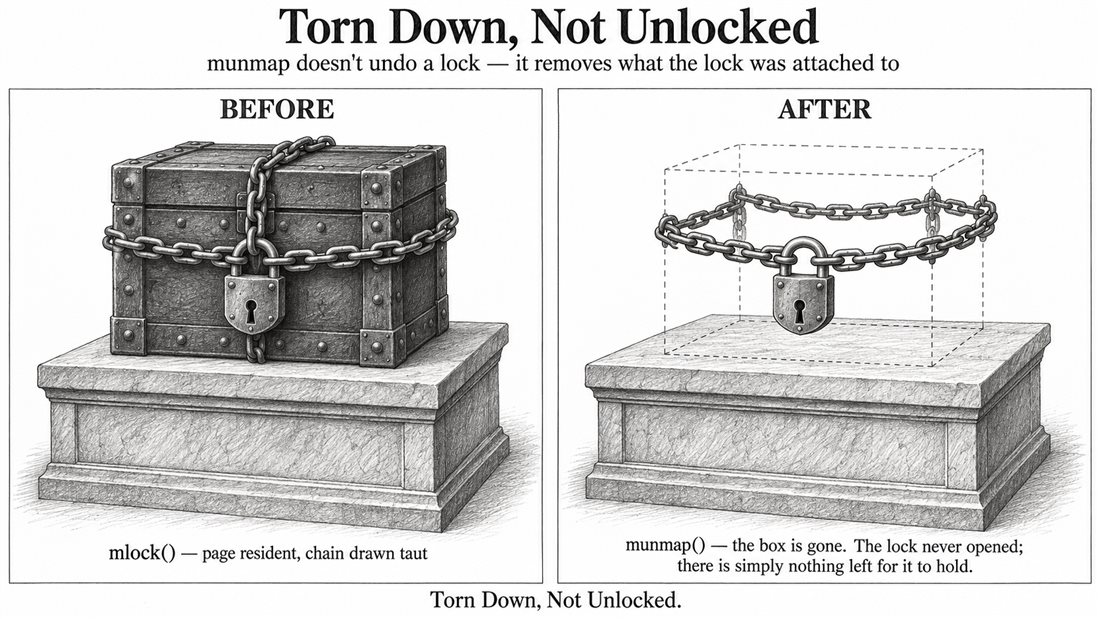
glibc 把内存还给内核有三条路,用三个 mallopt 各关一条:
| 设置 | 关掉的路 | 效果 |
|---|---|---|
M_MMAP_MAX = 0 | 大分配单独 mmap,free 时 munmap | 所有分配都走堆,free 只在堆里记账 |
M_TRIM_THRESHOLD = -1 | 堆顶空出一大块时,缩堆还给内核 | 堆只涨不缩 |
M_ARENA_MAX = 1 | 每个新 arena 各自 mmap 一块内存 | 只用主 arena;分配只在启动时发生,多 arena 减少锁竞争的好处用不上 |
启动时先设 mallopt,再锁页
mallopt(M_MMAP_MAX, 0);
mallopt(M_TRIM_THRESHOLD, -1);
mallopt(M_ARENA_MAX, 1);
mlockall(MCL_CURRENT | MCL_FUTURE);   // 需要 CAP_IPC_LOCK,或 RLIMIT_MEMLOCK 足够大
mallopt要在第一次大分配之前调:已经mmap出去的块不受影响。mlockall可能失败:权限或额度不够时返回错误,一页也不锁,启动时要检查返回值;补救办法见 3.2 的预先缺页。
2.2 TLB shootdown:改页表会打断别的核,isolcpus 挡不住
每个核的 TLB 缓存着虚拟地址到物理地址的翻译。一个核删掉映射(munmap)或收紧权限(mprotect)以后,别的核 TLB 里的旧翻译要作废,硬件不会自动同步,只能给正在跑这个进程的每个核发一个核间中断(IPI),让它们自己清。被打断的核要陷入内核、清掉 TLB 条目、再回来,这叫 TLB shootdown,一次几微秒。
isolcpus 挡不住它。 isolcpus 管的是调度器把线程放到哪个核上;shootdown 的 IPI 按“哪些核正在跑这个进程的地址空间”投递,和调度无关。热线程隔离、绑核做得再好,同一进程里一个冷线程 free 了一大块内存,热核照样被打断一次。
所以 2.1 关掉 glibc 的 munmap,除了省掉系统调用和缺页,也省掉了 shootdown。热路径进程跑起来以后,地址空间就不要再改了:透明大页的后台合并、自动 NUMA 平衡也会改页表,要一起关掉。完整的触发来源和关法见 TLB 专题 3.3。
3. STL 背后的 arena:一个只往前走的指针
对象池只发一种类型 T。真实的热路径代码想用 std::vector、std::string 这些普通 STL 容器——又不想让这些容器碰全局堆。这就意味着要写一个满足 C++ 分配器接口、背后是程序已经拥有的内存的东西。
3.1 一个只往前走的指针
struct MemoryBlock {
  size_t used, capacity;
  bool is_active;
  // ...
};
arena 从一块预留好的内存里分配,只跟踪一个数:这块内存已经用掉了多少字节。allocate(size) 把当前写入位置向上取整到要求的对齐,检查 used + size 还装不装得下 capacity,装得下就直接推进 used、返回旧位置——不用搜索,因为根本没什么可搜的:“下一个空闲位置”永远就是指针现在所在的地方。一块用满了,arena 用同样的方式启用下一块预留的内存。这比第 1 节的空闲链表还要便宜——连链表指针交换都没有,就是一次加法——代价是没办法从中间释放单独一次分配。没有任何东西记录每次分配从哪开始、到哪结束,所以就算你想释放一个也无从查起。唯一的回收操作是全局的:把每一块的 used 都倒回零,从头再来。对于一批生命周期完全相同的对象——处理一个 tick 时分配的所有东西,tick 处理完一起扔掉——这是正确的取舍;对于生命周期参差的对象则不然,它们还是属于第 1 节的池。
3.2 预先缺页:启动时把每一页都写一遍
arena 背后的内存在构造时一次拿到,用 posix_memalign 和 mlock(),这次只锁 arena 自己的这块区域,比第 2 节全进程的 mlockall 更精准。一段新拿到的虚拟地址范围,背后还没有物理内存:Linux 懒惰地映射页,真正的物理页要到第一次访问时才分配,靠的是一次陷入内核的缺页。mlock 成功返回时,会顺带把范围内的页都缺好、锁住。可它经常失败:没有 CAP_IPC_LOCK 时,能锁的总量受 RLIMIT_MEMLOCK 限制(常见默认值是 8 MB,老内核只有 64 KB),超了就返回错误,一页也不缺。
所以构造函数再加一行 memset(raw_memory, 0, total_size),在启动时把每一页写一遍。mlock 成功时,它只是多走一遍;mlock 失败时,页虽然没锁住,首次缺页也已经在启动时付掉了。等热路径运行时,arena 里的每一页都已经映射好,没有任何东西要第一次发生。
把这个 arena 适配到 STL 接口(allocate/deallocate/construct/destroy/rebind)的分配器,大部分是样板代码,知道它存在就够了,不必细究——只有一个例外:deallocate() 被故意写成空操作,原因和 reset() 是唯一回收内存的办法一样。单个对象的构造和析构仍然通过 construct/destroy 正常发生;被废掉的只有契约里“内存”的那一半。
3.3 参考实现:一个能直接用的 arena
arena 用于和池相反的情况:一批分配,大小可能不同、类型可能不同,最后一起释放。启动时的处理和 1.4 的池一样,分配逻辑更简单:没有空闲链表要维护,只有一个往前走的偏移 used_。
class Arena {
  unsigned char* base_;
  std::size_t capacity_;
  std::size_t used_ = 0;

 public:
  explicit Arena(std::size_t capacity) : capacity_(capacity) {
    base_ = static_cast<unsigned char*>(std::aligned_alloc(64, capacity_));  // capacity 要是 64 的倍数
    if (!base_) throw std::bad_alloc{};
    if (mlock(base_, capacity_) != 0) {
      // 同上:记一条日志
    }
    std::memset(base_, 0, capacity_);
  }

  ~Arena() {
    munlock(base_, capacity_);
    std::free(base_);
  }

  Arena(const Arena&) = delete;
  Arena& operator=(const Arena&) = delete;

  // alignment 必须是 2 的幂,且不超过 64
  void* allocate(std::size_t size, std::size_t alignment = alignof(std::max_align_t)) {
    std::size_t start = (used_ + alignment - 1) & ~(alignment - 1);  // 向上取整到对齐
    if (start + size > capacity_) return nullptr;                    // 装不下了
    used_ = start + size;                                            // 往前推
    return base_ + start;
  }

  void reset() noexcept { used_ = 0; }
};
allocate 就三步:把 used_ 向上取整到要求的对齐,检查装不装得下,把 used_ 推过这一块。base_ 按 64 字节对齐,所以偏移对齐了,地址也就对齐了,这也是 alignment 不能超过 64 的原因。
arena 不能单独释放一个对象,回收只有 reset() 一种。 它不记录每次分配,所以没法单独还一块;reset() 也不调析构函数,放进去的对象要么是平凡析构的,要么由调用方在 reset() 之前自己析构。和 3.1 的多块设计相比,这里只有一块固定大小的缓冲区,更容易写对,代价是容量有硬上限,用完返回 nullptr。
4. std::pmr:同一个答案,在运行时付钱
4.1 把分配器从类型里挪出去
第 3 节的自定义分配器有一个类型系统不会提醒你的锋利边缘:std::vector<int> 和 std::vector<int, LowLatencyAllocator<int>> 是两个毫不相干的类型。分配器是模板参数——是容器类型的一部分,不是一个运行时设置——所以一个写成接收 std::vector<int>& 的函数,会直接拒绝 arena 版本,每个需要两者都接收的函数也得在分配器上模板化。
std::pmr(C++17)用相反的方式解决同一个“让 STL 用我的分配策略”的问题:把策略的选择从类型里挪出去,放进一个运行时指针。std::pmr::memory_resource 是一个抽象基类——do_allocate、do_deallocate、do_is_equal——任何具体的分配策略都通过继承它来表达。所有 std::pmr 容器都用同一个统一的 std::pmr::polymorphic_allocator<T>,它里面只有一个 memory_resource*;因为这个指针具体指向什么不是类型的一部分,std::pmr::vector<int> 不管背后是哪个 resource,永远是同一个类型——随便传、随便赋值、随便返回,不用任何模板体操。代价在每一次分配时付:通过那个指针的一次虚调用,运行时分派,而第 3 节的版本里具体的分配器类型在编译期就知道,可以被完全内联掉。这正是 C++ 程序员在虚函数和模板之间早就在权衡的静态多态 vs 动态多态,只是这次用在了内存本身上。
4.2 标准库自带的 resource,对应第 1 节和第 3 节
标准库自带了几个 resource,直接对应前面讲过的东西:
monotonic_buffer_resource就是标准化的第 3 节 arena:只往前分配,一起释放,不能单独回收。它甚至接受调用者提供的初始缓冲区(比如栈上的一个std::array),外加一个溢出时用的后备 resource——标准库版本的allow_fallback_参数。unsynchronized_pool_resource更接近第 1 节的池,推广到了多种对象大小而不是一个固定类型,按大小类别管理成一个个 “slab”。synchronized_pool_resource是上面那个的线程安全版——名字已经说明了它的代价:一把锁,正是这整篇文章想要避免的那一类竞争。
4.3 生命周期陷阱
std::pmr::vector 看上去和普通的值类型一模一样——按值返回一个,似乎和返回任何别的 std::vector 一样安全。并不是,原因很具体:polymorphic_allocator 只是指向它的 memory_resource,从不拥有它。如果那个 resource 是一个局部变量,返回 vector 对延长 resource 的生命周期毫无帮助:
auto create_vec() -> std::pmr::vector<int> {
  auto resource = PrintingResource{};           // 局部变量,出作用域就销毁
  auto vec = std::pmr::vector<int>{&resource};  // vec 只存了 &resource
  return vec;                                   // resource 在这里被销毁
}
auto vec = create_vec();
vec.emplace_back(1);  // 未定义行为
vec 本身干干净净地移出来了——没有深拷贝,返回这一步看不出任何问题。危险在调用处是看不见的,恰恰因为 std::pmr::vector<int> 摆出和 std::vector<int> 一样的值语义,却并不拥有它的正确性所依赖的那个东西。这逼出来的规则毫不起眼,但没有例外:memory_resource 的生命周期必须长过建在它上面的每一个容器——这通常意味着它得住在一个严格更外层的作用域里,绝不能放在那个只是构造并返回容器的函数里面。
4.4 对象池、arena 还是 std::pmr:看对象怎么释放
按对象怎么释放来选
- 对象一个一个分配、一个一个释放,类型固定:用对象池。分配和释放都只动空闲链表的头,O(1)。
- 一批对象一起用完、一起扔掉(处理一个 tick、一笔订单时碰到的所有临时对象):用 arena。分配就是一次加法,不能单独释放,用完整体
reset()。- 同一种容器类型要换着用不同的内存来源:用
std::pmr。它解决的是类型兼容,不是性能,每次分配多一次虚调用,热路径上不如前两种。
5. 多线程分配:无锁空闲栈和 ABA
1.4 的池只能在一个线程里用:两个线程同时读 free_head_,会拿到同一个槽。要让几个线程同时分配,就把链表头换成原子变量,用 CAS 取下它:读出 head 和它的 next,再 CAS 把 head 从读到的值换成 next;这期间别的线程改过 head,CAS 失败,重读重试。空闲链表只在头上进出,所以它就是一个无锁栈。
5.1 ABA:CAS 只比较值,看不出它变过又变回来
这种栈有一个经典的坑,叫 ABA:CAS 只比较值,看不出这个值中间变过、又变了回来。 名字说的就是 head 从 A 变成 B,又变回 A。下面用 X、Y、Z 表示三个空闲槽,栈里一开始是 X → Y → Z:
| 时刻 | 线程 A(分配) | 别的线程 | 空闲栈 |
|---|---|---|---|
| 1 | 读到 head = X、X.next = Y,还没 CAS 就被换下 | X → Y → Z | |
| 2 | 线程 B 分配两次,拿走 X 和 Y | Z | |
| 3 | 有线程把 X 还回来 | X → Z | |
| 4 | CAS:head 还是 X,成功,head 改成 Y | Y → Z,可 Y 正被 B 用着 |
时刻 4 以后,下一次分配会把 Y 再发出去,同一个槽同时给了两个使用者;刚还回来的 X 反而从栈里丢了,再也分不出去。
5.2 修法:链表头带一个版本号
修法是给 head 带一个版本号,每改一次加 1,CAS 同时比较下标和版本号。 时刻 1 线程 A 读到的是(X,版本 5);时刻 2、3 一共改了三次,head 变成(X,版本 8)。A 拿(X,5)去比,不相等,CAS 失败,重读以后重试。
槽用 32 位下标表示,下标和 32 位版本号正好打包进一个 uint64_t,普通的 64 位 CAS 就能一起比较。链表要是用指针,就得用 16 字节的 CAS(x86-64 的 cmpxchg16b),或者把版本号塞进 64 位指针用不到的高 16 位。版本号会回绕,但那要求线程 A 被换下的这一会儿里正好错过 $2^{32}$ 次修改,实际不会发生。
template <typename T>
class ConcurrentPool {
  struct Slot {
    alignas(T) unsigned char storage[sizeof(T)];
    std::atomic<std::uint32_t> next;              // 空闲时:下一个空闲槽的下标
  };
  static constexpr std::uint32_t kNil = UINT32_MAX;
  static std::uint64_t pack(std::uint32_t ver, std::uint32_t idx) {
    return (std::uint64_t(ver) << 32) | idx;      // 高 32 位版本号,低 32 位下标
  }

  Slot* slots_;                                   // 分配、mlock、memset、串链表同 1.4
  std::atomic<std::uint64_t> head_;               // 初值 pack(0, 0)

 public:
  template <typename... Args>
  T* allocate(Args&&... args) {
    std::uint64_t old = head_.load(std::memory_order_acquire);
    for (;;) {
      std::uint32_t idx = static_cast<std::uint32_t>(old);
      if (idx == kNil) return nullptr;
      std::uint32_t next = slots_[idx].next.load(std::memory_order_relaxed);
      std::uint64_t desired = pack(static_cast<std::uint32_t>(old >> 32) + 1, next);
      if (head_.compare_exchange_weak(old, desired,
                                      std::memory_order_acquire,    // 成功
                                      std::memory_order_acquire))   // 失败:old 被换成最新值
        return ::new (slots_[idx].storage) T(std::forward<Args>(args)...);
    }
  }

  void deallocate(T* obj) {
    obj->~T();
    auto* slot = reinterpret_cast<Slot*>(
        reinterpret_cast<unsigned char*>(obj) - offsetof(Slot, storage));
    std::uint32_t idx = static_cast<std::uint32_t>(slot - slots_);
    std::uint64_t old = head_.load(std::memory_order_relaxed);
    for (;;) {
      slot->next.store(static_cast<std::uint32_t>(old), std::memory_order_relaxed);
      std::uint64_t desired = pack(static_cast<std::uint32_t>(old >> 32) + 1, idx);
      if (head_.compare_exchange_weak(old, desired,
                                      std::memory_order_release,
                                      std::memory_order_relaxed))
        return;
    }
  }
};
用 GCC 16.2 跑过一个压力测试:8 个线程共用一个 64 槽的池,各自分配、释放 20 万次,没有一个槽同时发给两个线程,结束后 64 个槽全部收回。
5.3 内存序:分配用 acquire,释放用 release
- 分配时的读和 CAS 都用 acquire:拿到槽的线程,要看得到上一个使用者释放前写进这个槽的内容,也要看得到释放时写下的
next。CAS 失败时会把最新的head读回old,下一轮接着要读它的next,所以失败的那一路也要 acquire。 - 释放的 CAS 用 release:这个槽里的写入和刚写下的
next,随着这次 CAS 一起发布给下一个拿到它的线程。
next 单独放、做成 std::atomic,不和 storage 共用字节,是因为时刻 1 的线程 A 读 X.next 时,X 可能已经被别的线程拿走、正在往 storage 里构造对象。两者分开,这次读就不是数据竞争;读到的旧值会随着失败的 CAS 被丢掉。
5.4 槽不还给系统:省掉了无锁栈最难的回收问题
一般的无锁栈弹出节点以后会 delete 它,别的线程可能还拿着它的地址要读 next,读的就是已经释放的内存,这要靠 hazard pointer、epoch 这类回收方案解决。池里的槽一直都在,最多读到过时的 next,这个值会随着失败的 CAS 被丢掉。