
行情剧烈波动时,策略线程要在几微秒里处理完一个包、发出订单。如果这期间它被别的任务抢占一次,或者它的 L1、L2 被别的任务冲掉一次,这一个包就可能多花几十微秒,订单排到别人后面,成交价差一个 tick。所以低延迟系统怕的是尾延迟和抖动,不是平均延迟:平均 2 µs、偶尔冲到 50 µs,不如每次都稳定在 5 µs。
抖动来自三个地方:别的东西抢这个核,核自己的状态在变,以及数据放在离核远的内存里。这篇按这个顺序处理,目标只有一个:让热线程成为它那个物理核上唯一在跑的东西,而且一直如此。
1. 绑核与隔离:让这个核上只跑你的线程
1.1 迁移:线程换了核,缓存不跟着走
Linux 调度器(6.6 以前是 CFS,之后是 EEVDF)为了负载均衡,会在核之间挪线程:它看到 3 号核空着、8 号核上排着两个任务,就把一个挪到 3 号核。对“所有核都用起来”这个目标来说这没错,对热线程却很贵。
贵在 L1、L2 和 TLB 都是每个物理核私有的。 线程在 7 号核上跑了一阵,订单簿的热数据、策略代码的指令、地址翻译条目,都在 7 号核的缓存里。被挪到 12 号核以后,12 号核的缓存里一样都没有,接下来的访存几乎都要去 L3(约 40 个周期)或内存(约 200–300 个周期)重新拿。工作集越大,这段重新暖缓存的时间越长,几微秒到几十微秒不等,这期间线程只能干平时的一小部分活。迁移要是跨了插槽,数据还变成了远端内存,此后每次访问都更慢(第 3 节)。
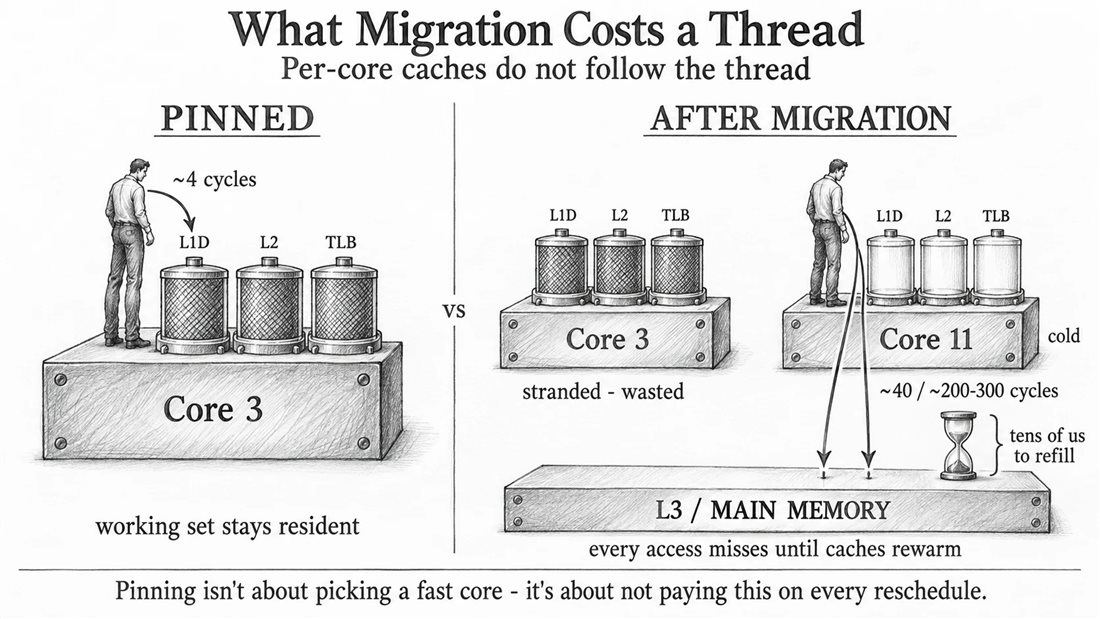
1.2 绑核(affinity):把线程钉在一个核上
绑核就是告诉调度器:这个线程只能在这几个核上跑。只给一个核,迁移就不会再发生。
cpu_set_t set;
CPU_ZERO(&set);
CPU_SET(3, &set);                                       // 只允许 3 号核
pthread_setaffinity_np(pthread_self(), sizeof(set), &set);
cpu_set_t 是一个位掩码,每一位代表一个核,CPU_ZERO、CPU_SET 是操作它的宏。pthread_setaffinity_np 是 glibc 的封装,用 pthread_t 指定线程,_np 表示 non-portable,不是 POSIX 标准;它底下调用的系统调用是 sched_setaffinity,用线程 ID 指定,传 0 表示调用者自己。命令行上对应的是 taskset -c 3 ./app。
新线程默认继承创建者的 affinity,先在创建者允许的核上跑起来,到自己调 pthread_setaffinity_np 时才迁到目标核。要连这一次迁移也省掉,就在创建时把 affinity 写进线程属性,线程从第一条指令起就在目标核上:
pthread_attr_t attr;
pthread_attr_init(&attr);
pthread_attr_setaffinity_np(&attr, sizeof(set), &set);   // set 同上,只含 3 号核
pthread_create(&tid, &attr, hot_loop, arg);
pthread_attr_destroy(&attr);
std::thread 没有传线程属性的入口,所以热线程要么用 pthread_create 这样创建,要么在线程函数的第一行就调 pthread_setaffinity_np。
绑核只管住了你的线程,挡不住别人来这个核。 线程钉在 3 号核以后,3 号核上的时钟中断、软中断、内核线程、别的用户进程照样在,照样会打断它。要让这个核上只剩你,还得把别人挡在外面,这是隔离要做的事。
1.3 隔离:把别的打断一类一类赶走
一个没做任何配置的核,每秒会被下面这些东西打断:
| 打断来源 | 怎么打断热线程 | 对策 |
|---|---|---|
| 别的用户线程 | 调度器把它们放到这个核上,和热线程轮流跑 | isolcpus=3 |
| 周期时钟中断(tick) | 每秒 100–1000 次,做时间片统计和记账 | nohz_full=3 |
| RCU 回调 | 内核 RCU 机制回收旧数据时,要在某个核上执行回调 | rcu_nocbs=3(nohz_full 会自动带上) |
| 设备中断 | 网卡每收一批包就打一次硬中断,接着还有软中断 | irqaffinity=0,1,再逐个设 /proc/irq/N/smp_affinity |
| 每个核自带的内核线程 | ksoftirqd/3、kworker/3:* 有活时醒来 | 关不掉,把活源断掉,它们就一直睡着 |
| NMI watchdog | 周期性的不可屏蔽中断,检查内核有没有卡死 | nmi_watchdog=0 |
前四个对策都是内核启动参数,写在内核命令行里,改了要重启。下面几点是容易理解错的地方。
isolcpus 挡的是自动调度,不挡你显式绑上去。 它做两件事:系统里所有进程默认的 affinity 都不再包含 3 号核,所以没有任务会被自动放上去;调度器也不再拿 3 号核做负载均衡。可它不是一堵权限墙,你的程序用上一节的 API 把热线程绑到 3 号核,照样能跑上去。标准用法正是这样:isolcpus 把 3–7 号核清空,程序再把热线程一个一个绑上去,一个线程独占一个核。
nohz_full 只在这个核上恰好只有一个可运行任务时才停掉 tick。 tick 的用处之一是在几个任务之间分时间片,只剩一个任务时没什么可分,内核才敢把它停掉。核上一旦有第二个可运行的线程,tick 立刻恢复。所以 nohz_full 和“一个线程独占一个核”是绑在一起的,热核上不能再放第二个线程。
每个核自带的内核线程删不掉,但可以让它们没活干。 ksoftirqd/3 处理 3 号核上积压的软中断,网卡中断引到打杂核以后,3 号核不再产生网络软中断,它就一直睡着;kworker/3:* 处理派到 3 号核的工作项,中断和 RCU 回调都挪走以后,派给它的活也接近零。
这样配置下来,没有被隔离的核(通常是 0 号,有时加上 1 号)叫打杂核(housekeeping core)。系统的打断并没有消失,只是全被赶到了打杂核上,换来热核上的安静。
就算全部配好,热核上还剩一点关不掉的东西:nohz_full 核上仍有大约每秒 1 次的残余 tick;同一进程里别的线程调 munmap、mprotect 改了地址空间,热核会收到 TLB shootdown 的核间中断(IPI);还有 SMI,这是固件层面的系统管理中断,操作系统看不见,一次几十到几百微秒,只能在 BIOS 里处理。用 cyclictest 或 oslat 测出来的最大延迟,就是这些残余定下的“地板”。
1.4 isolcpus、cpuset、taskset:谁挡别人,谁管自己
这几个工具常被放在一起说“隔离强弱”,其实它们做的是两件不同的事:
| 手段 | 作用在哪 | 做什么 | 能不能运行时改 |
|---|---|---|---|
isolcpus | 内核启动参数 | 所有进程默认不在这些核上跑,调度器也不往上面做负载均衡 | 不能,改了要重启 |
cpuset(cgroup) | 一组进程 | 划出一组核和内存节点,组里的进程只能在里面跑;别的组可以划到别的核上 | 能 |
taskset、sched_setaffinity、pthread_setaffinity_np | 一个进程或线程 | 只限制被设置的这一个能在哪些核上跑 | 能 |
前两种把别人挡在外面,最后一种只把自己钉在里面,所以说后者是“弱隔离”:它不阻止别的线程也跑到同一个核上。实际部署两边配合使用:用 isolcpus 或 cpuset 把核清出来,再用 affinity 把热线程放上去。cpuset 比 isolcpus 多两样能力:运行时就能调整,而且能连内存节点一起划,在 NUMA 机器上有用(第 3 节)。内核文档现在更推荐 cpuset,生产上 isolcpus 仍然常见,因为它简单,开机就生效。
1.5 选核:别用 0 号核,热核放在网卡那一侧
0 号核是 Linux 的启动 CPU,很多杂事默认落在它上面:RCU 的宽限期线程、默认工作队列、一些迁不走的中断、计时。别的核全隔离了,这些杂事也还集中在 0 号核,有时溢到 1 号核。所以0、1 号核留给打杂,热线程放在别的核上。双路机器上,热核还要选在网卡所在的那颗 CPU 上,否则每个包都要跨一次插槽(第 3 节)。选核之前先用 lscpu -e=CPU,CORE,SOCKET,NODE 看清楚每个逻辑 CPU 属于哪个物理核、哪个插槽。
2. 超线程、C-state、睿频:核自己也会抖
第 1 节把别人赶出了这个核。可就算整个核都归热线程,核本身还有三个特性会让同一段代码时快时慢。
2.1 超线程(SMT):一个物理核装成两个
超线程让一个物理核表现成两个逻辑 CPU,比如操作系统看到的 CPU 0 和 CPU 48,其实是同一个物理核上的两套寄存器。一套停下来等内存时,核去执行另一套的指令,填上空闲的执行单元,吞吐通常能多 15%–30%。
两个逻辑 CPU 共享几乎所有要紧的东西:执行单元、L1、L2、store buffer、TLB、分支预测器。热线程钉在 CPU 0 上,以为独占了一个核;另一个任务被放到 CPU 48 上,它跑 AVX 时占着浮点单元,它的访存冲掉两者共用的 L1,热线程就得等、得重新加载数据。
先看清楚谁和谁是兄弟:
lscpu -e                                                          # CORE 列相同的就是同一个物理核
cat /sys/devices/system/cpu/cpu0/topology/thread_siblings_list    # 直接列出 CPU0 的兄弟
cat /sys/devices/system/cpu/smt/active                            # 1 表示 SMT 开着
最彻底的是在 BIOS 里关掉超线程,或者在内核命令行加 nosmt。不想全局关,就只把热核的兄弟下线:
echo 0 > /sys/devices/system/cpu/cpu48/online # CPU48 下线,CPU0 独占整个物理核
2.2 C-state:核空闲时会睡,叫醒要时间
C-state 是核空闲时的省电状态。C0 是在干活,C1、C1E 是浅睡,C6 是深睡:越深越省电,醒来越慢。C6 会把核断电,L1、L2 的内容也就没了,从 C6 回到 C0 大约要 30–150 µs。
热线程的节奏如果是“处理一个包,空闲一会儿”,核就可能在空闲时滑进 C6,下一个包到达时,先花几十微秒叫醒核,再从空缓存开始干活。这种尖刺只在空闲之后出现,平时压测连续灌包时看不到,所以很难发现。
三种修法,从粗到细:
idle=poll(内核启动参数):核空闲时不进任何 C-state,原地轮询。延迟最低,功耗和发热也最高。- 限制最深能进到哪一级:启动参数
processor.max_cstate=1 intel_idle.max_cstate=1,或者运行时对每一级写/sys/devices/system/cpu/cpuN/cpuidle/stateX/disable。允许浅睡,不许深睡。 - 程序里打开
/dev/cpu_dma_latency,写入 32 位整数0,并且一直不关这个文件描述符:意思是“全系统能容忍的唤醒延迟是 0 µs”,内核就不让核进深睡。fd 一关,约束就解除,所以只在程序运行期间生效,不用改启动参数。
2.3 P-state 和睿频:频率会变,执行时间就跟着变
P-state 管的是频率和电压,有两样东西会让它变:
- 调频策略(governor)会按负载慢慢升频:默认的
powersave看到负载上来升一档,再看再升,线程突然忙起来时,前几个包是在低频下处理的。换成performance,频率一直停在最高档。 - 睿频(Turbo)让频率随环境浮动:散热和功耗有余量时,核会跑到额定频率以上,具体多高取决于有几个核在忙、机器有多热、指令里有没有重度 AVX(会降频)。频率一变,每段代码的执行时间都跟着变。
HFT 的常见做法是关掉睿频,把频率钉在一个固定值上,放弃峰值速度,换每次执行时间都一样:
cpupower frequency-set -g performance
cpupower frequency-set -d 3.5GHz -u 3.5GHz               # 下限等于上限,频率钉死
echo 1 > /sys/devices/system/cpu/intel_pstate/no_turbo   # 关掉睿频
超线程、C-state、睿频都是为平均效率、省电或峰值吞吐设计的,这些目标和“每次执行时间都一样”相冲突。热核的处理办法都一样:关掉兄弟线程,不许深睡,频率钉死,放弃核的一部分能力和全部弹性,换来可预测。
3. NUMA:内存离核有远有近
3.1 本地访问和远端访问
双路服务器有两颗 CPU,每颗直接连着一部分内存条,一颗 CPU 加上它直接连着的内存叫一个 NUMA 节点。CPU 0 读自己节点上的内存是本地访问,约 80–100 ns;读 CPU 1 节点上的内存,请求要经过两颗 CPU 之间的互连(Intel 叫 UPI,AMD 叫 Infinity Fabric)送过去,由 CPU 1 的内存控制器取出来再送回来,这是远端访问,约 130–150 ns。
numactl --hardware 会打印一个 node distances 矩阵,本地是 10,远端常见的是 21。这是固件给出的相对值,只说明远端更远,不等于真实的延迟倍数,实测远端大约是本地的 1.5 倍。
远端访问的代价不是偶尔一次的尖刺,而是每次访问都要多付的固定成本。 热线程在节点 0 的核上,订单簿却分配在节点 1,它每碰一次订单簿都慢几十纳秒,整个延迟分布一起往右平移。这和 C-state 那种“空闲后才出现”的尖刺是两种形状,前者看均值和中位数就能发现,后者只在尾部。
图:打杂核(0、1 号)吸收设备中断和内核杂事;3 号核用启动参数清出来,再把热线程绑上去;访问节点 1 的内存要经过 UPI,每次约多 50 ns。
3.2 无意中跨 NUMA:first-touch 把页放在第一次写它的核所在的节点
malloc(1GB) 返回时,Linux 并没有真的分配 1 GB 物理内存,只是在地址空间里留出一段虚拟地址。某一页第一次被写时,触发缺页,内核才分配物理页,而且默认放在执行这次写的核所在的节点上,这叫 first-touch。
所以决定内存落在哪个节点的,是第一次写它的线程,不是调用 malloc 的线程。 常见的错误是:主线程 malloc 一大块、顺手 memset 清零,整块内存就落在了主线程所在的节点;然后工作线程被绑到另一个节点的核上去用它,每次访问都是远端。正确的做法是谁用谁初始化:分配完先别碰,让最终用它的线程在自己的核上做第一次写。
3.3 membind、preferred、interleave:节点内存不够时怎么办
numactl 和 libnuma 可以指定内存从哪个节点分配,三种策略的区别在于目标节点不够用时的行为:
| 策略 | 分配到哪 | 目标节点满了 | 适合 |
|---|---|---|---|
--membind=0 | 只从节点 0 分配 | 先拼命回收节点 0 的内存,再不够就失败或 OOM,哪怕节点 1 还有空闲 | 热路径,要保证一定是本地 |
--preferred=0 | 优先节点 0 | 退到别的节点分配 | 不能接受 OOM,可以接受偶尔远端 |
--interleave=all | 按页轮流分到各节点 | 不存在这个问题 | 扫大量内存的分析任务,把带宽压力摊到所有内存控制器上 |
membind 的回收本身就是一阵抖动,所以严格绑定时要自己盯着目标节点的剩余内存、提前留够,而不是一出问题就放宽成 preferred,那等于放弃了本地性的保证。
程序里用 libnuma 的 numa_alloc_onnode()、numa_run_on_node(),底下的系统调用是 mbind(2)、set_mempolicy(2)。诊断用 numastat -p <pid>,看每个节点分了多少内存,numa_miss、numa_foreign 有没有在涨。
3.4 share-nothing:每份可变数据只归一个线程
上面的策略都是在数据已经被多个线程共享以后补救。低延迟系统更常见的做法是从结构上不让数据共享,叫 share-nothing:每份可变的数据只属于一个线程,只有这个线程读写它;线程之间不共享状态,只传消息。
以行情和策略为例:200 个合约,4 个策略线程。按合约分片,合约 i 归线程 i mod 4,这个合约的订单簿、持仓、策略状态只由这个线程读写。行情线程解码出一条消息,看它属于哪个合约,就放进那个线程的队列。
这样分以后,前面几节想要的东西都拿到了:
- 不需要锁:一份数据只有一个线程写,没人和它抢,锁就没有存在的必要。
- 缓存行不在核之间来回搬:几个线程共用一份订单簿时,一个线程写一次,别的核缓存里的那一行都要作废,它们下次读都是未命中(MESI)。数据只在一个核上用,就没有这种作废。
- 内存都是本地的:线程绑在哪个节点的核上,就由它自己第一次写自己的数据(3.2),之后的访问全是本地访问。
线程之间还是要传东西,比如行情线程把消息交给策略线程。传的通道是单生产者单消费者(SPSC)队列。消息放进队列以后,行情线程就不再碰它,策略线程取出来以后它只归策略线程,任何时刻每份数据仍然只有一个主人,只是主人随着队列换了人。真正被两个线程共享的只剩队列的两个下标,这是通信必须留下的最小共享,它守的是单写者原则:每个变量只有一个写者,别的线程可以读。 尾下标只有生产者写、消费者读,头下标只有消费者写、生产者读,所以用 acquire / release 就能同步,不需要锁(#4)。无锁不是额外加的要求,而是“每个变量只有一个写者”自然带来的结果。
换成 mutex 就违背了这个原则:锁本身是一个两边都要写的变量。 生产者和消费者每次读写队列都要先 lock(),这是对锁变量的一次原子读改写,所以没人抢时,锁所在的缓存行也要每条消息在两个核之间搬一次;有人抢时,拿不到锁的线程会睡下去,被叫醒要几微秒到几十微秒,正好落在尾延迟上。锁是用来让多个写者排队的,SPSC 里每个变量本来就只有一个写者,锁只剩成本。不在热路径上的队列(比如每秒几次的管理消息)用 mutex 加条件变量没问题,还省得一直轮询。
代价是跨分片的事要靠消息来做。比如风控要看全部合约的总持仓,就得由各策略线程把持仓变化发给风控线程,风控看到的汇总会晚一点。所以分片时要尽量把总是一起用的数据分到同一个线程,比如同一个标的的期货和期权。
把一个核清出来给热线程:配置清单
- 看拓扑:
lscpu -e=CPU,CORE,SOCKET,NODE找出每个核的兄弟和所在节点,确认网卡在哪个节点(/sys/class/net/<网卡>/device/numa_node)。- 内核命令行:
isolcpus=3-7 nohz_full=3-7 rcu_nocbs=3-7 irqaffinity=0,1 nmi_watchdog=0,热核选在网卡那个节点上,避开 0、1 号核。- 核自身:热核的超线程兄弟下线;
idle=poll或限制 C-state,或在程序里持有/dev/cpu_dma_latency;governor 设成performance,关睿频,把频率钉死。- 程序里:每个热线程绑一个隔离核,一个核只放一个线程;热数据由用它的线程自己第一次写,或用
membind分到本节点。- 验证:
cyclictest或oslat测热核上的最大延迟,/proc/interrupts看热核上的中断计数是否还在涨,numastat -p看有没有跨节点分配。