
wait-free
wait-free 不是更快的 lock-free:它把 CAS 失败从“再来一次”变成“我排在你后面”,每个线程的步数因此有了上界,代价是更多原子操作和更难写对的代码。
wait-free 不是更快的 lock-free:它把 CAS 失败从“再来一次”变成“我排在你后面”,每个线程的步数因此有了上界,代价是更多原子操作和更难写对的代码。
先用 stat 看总账,再用 record 和 report 找到占 98% 样本的函数,最后用 annotate 看到样本全落在加法后面一条指令上:那是一条一环扣一环的加法链,拆成四路就快了 3.3 倍。拿不到硬件计数器时,cpu-clock 采样照样能用;报告里只剩地址,先查符号表和程序所在的路径。
自旋锁快不快,看等锁的核在干什么:每次都读改写,就把锁所在的行抢来抢去;先读后抢、循环里加 PAUSE、抢输了退一步,等的时候才几乎不打扰持锁的核。
一条行情要碰 140 条缓存行,时间大多花在等它们。四步改的都不是计算,是数据什么时候到、到哪一层、在谁手里:让缺失同时在路上,提前要下一批,交出读一次就没用的行,跨核交接时少读一次,把要给对面读的行先放进 L3。
一条指令算一排数,前提是编译器知道能用多宽的寄存器、确定没有重叠、允许重排;这三条做不到时,用 intrinsics 自己写,代价是对齐、指令集检测和结果的最后几位。
让数据先到缓存里有三种办法,各有前提:预取要你比硬件先知道地址,预热要在读数据的那个核上做,双缓冲要保证写的一方不会回到读的一方还没读完的那一份。
编译器能优化到什么程度,取决于它看得见什么、敢假设什么:类型不同就当成不重叠,看不见函数体就照调用约定传参,提示宏是你直接替它做的决定,有的决定并不对。
编译器只做它能证明结果不变的替换,常数乘除它做得比人好;要人动手的,是它缺信息或者换了结果会变的地方:运行时的除数、符号、浮点。价格用整数存,精确也快。
点积循环 -O3 报告“已向量化”,四个加法却还是一个等一个:浮点加法不满足结合律,编译器不敢换顺序。循环优化真正要你管的,是这类挡住编译器的地方,和它不会替你做的改动。
基类写流程、子类填细节,虚函数在运行时选,CRTP 在编译期选。省下的不只是一次间接跳转:调用能整个内联,对象里也没有 vptr。代价是 Base 和 Base 毫无关系,放不进同一个容器。
按值返回结构体通常是零成本的,不用改成传出参数;要留意的是几种一定会移动或拷贝的写法。纯函数属性是向编译器做承诺:说对了少调几次,说错了是未定义行为。
a[i] = *b 这种循环,编译器每轮都要重读 *b,因为写 a[i] 可能改掉它。指针优化做的事,就是让编译器敢少读,让链表装进更近的缓存。
前端每个周期都要取指令,可一条分支要十几个周期后才算出往哪走,所以只能先猜。猜对几乎不花钱,猜错要把之后的活全部扔掉,约 15–20 个周期。同一条 if,数据有规律就猜得准,随机就只能猜对一半;而编译器可能早已把它变成了 cmov。
一次内存访问约 100 ns、运回 64 B,一次一个只有 0.64 GB/s,可一个核顺序读能拿到 15–60 GB/s,差出来的倍数就是同时在路上的请求数。下一次读的地址要不要等这一次读回来,决定了代码受延迟还是受带宽限制。
线程比进程轻,轻在切换之后 TLB 和缓存还能接着用,不在切换本身。TLB 没有 MESI:同一个进程里任何一个线程改了页表,此刻还装着这份页表的核都要被打断一次,绑核和 isolcpus 挡不住,所以热路径进程跑起来以后地址空间只读不改。
访问从来不按字节付钱,按缓存行付;地址决定了碰哪几条行、这些行争哪个缓存组、住在哪个 DRAM 通道和 bank。第一部分讲对齐:为什么按 8 对齐的 double 不会跨行、填充为什么是为了数组、alignas 写在类型上和成员上的区别、堆上怎么拿 64 和 2 MiB 对齐。第二部分讲布局:一次访问碰几条行,AoS 还是 SoA,去规范化砍掉的是依赖链。第三部分进到硬件:L1 用地址的 bit 6–11 选组,相差 4 KiB 的数据不管缓存多空都在抢 …
行情只有一个生产者,却有好几个消费者,每个都要看到每一条,而生产者是热路径,不能等任何人。答案是广播环:每个槽位自带序号戳,读者各持私有游标,生产者写满一圈就覆盖最老的槽位,从不读读者的状态。代价转给了读者:套圈是无声的;读完再复查一次戳,只有在写者先作废戳的前提下才抓得到写了一半的槽位;追上来的读者会抢走生产者要写的那一行,全速写时每条都变贵。放进共享内存再加三条:元素里不能有任何指针,第一圈每 32 条碰一次缺页,读者重启不存游标就全丢。
MESI 只执行一条规矩:一条缓存行,要么只有一个核能写,要么有任意多个核只能读,两者不会同时存在。四个状态就是两个问题的答案——别人有没有这一行?我改过没有?协议里的每一笔代价,不是在层与层之间搬数据,就是在等另一个核确认。伪共享、SPSC 队列的缓存游标、读者越多生产者越慢,都是同一台状态机。一致性仍然不保证多字读取不撕裂,也不管不同地址的写谁先谁后,那是内存屏障的事。
无锁 SPSC 队列成立,是因为每个共享变量只有一个写者:每一边只写自己的下标,只读对方的。剩下的工作是别让这个性质被悄悄破坏:元素个数用两个下标相减而不是共享计数器,对方的下标缓存一份、只在看起来满了或空了时才刷新,日志按文本段推而不是按字符推。SPSC 只在“失败就返回”的接口下才是 wait-free,有界队列满了总得在丢弃和阻塞之间选一个。
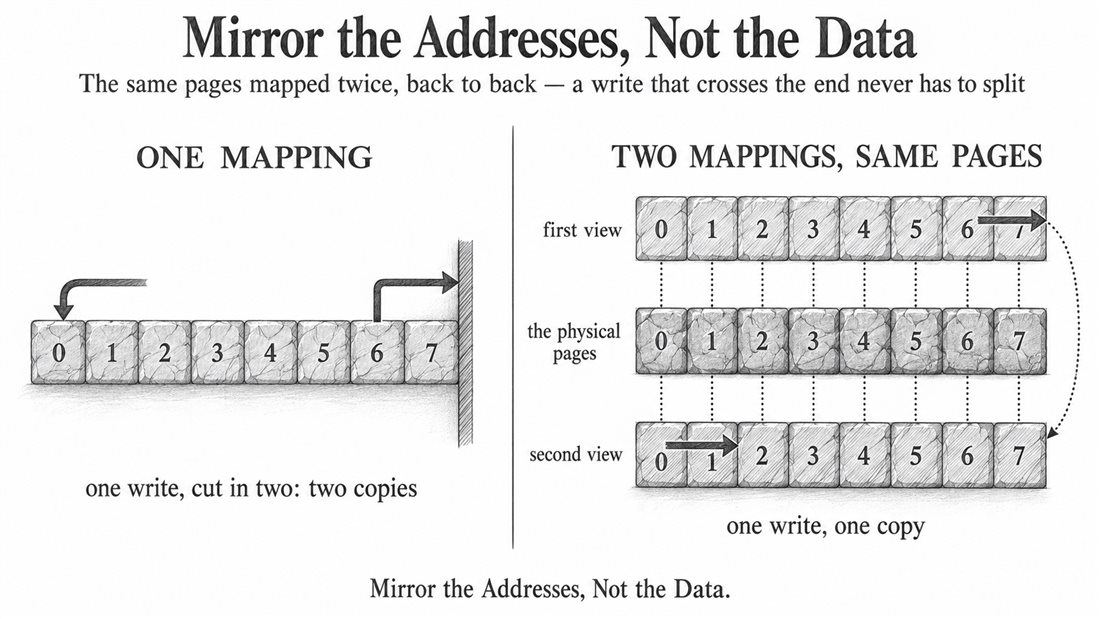
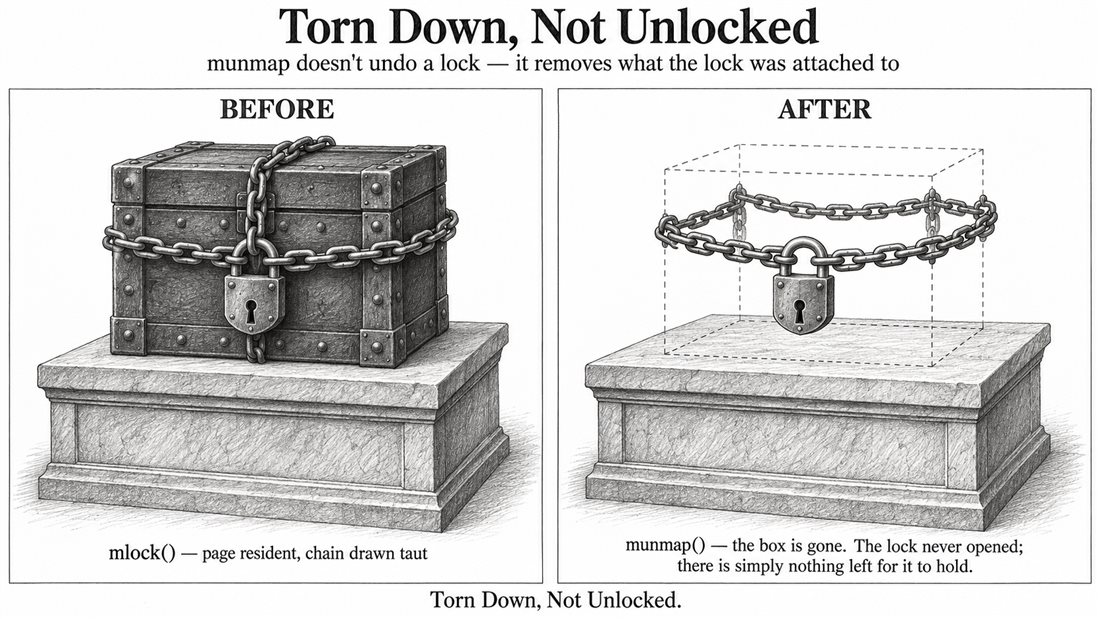
这篇里的每一种技术,都是在不同的层面上做同一件事:把一个不确定的、牵涉内核的操作从热路径上挪走,强制它在开头一次性发生完,不让它伏击任何一个请求。对象池用永远 O(1) 的空闲链表,换掉 malloc 那种耗时可变的搜索。mlockall 加上仔细的 mallopt 调优,阻止内核悄悄把页收回——预先缺页则补上 mlock 单独留下的那个口子。手写的 arena 分配器让 STL 本身配合一个由 bump 指针内存支撑的自定义分配器。std::pmr 用标 …
同一套缓存硬件带出两个不相干的问题。正确性:写先进 store buffer,别的核要过一段时间才看得见,靠 release/acquire 配对补上顺序。性能:就算每个值都读对了,两个核抢同一条缓存行(伪共享)照样慢,靠缓存行布局解决。
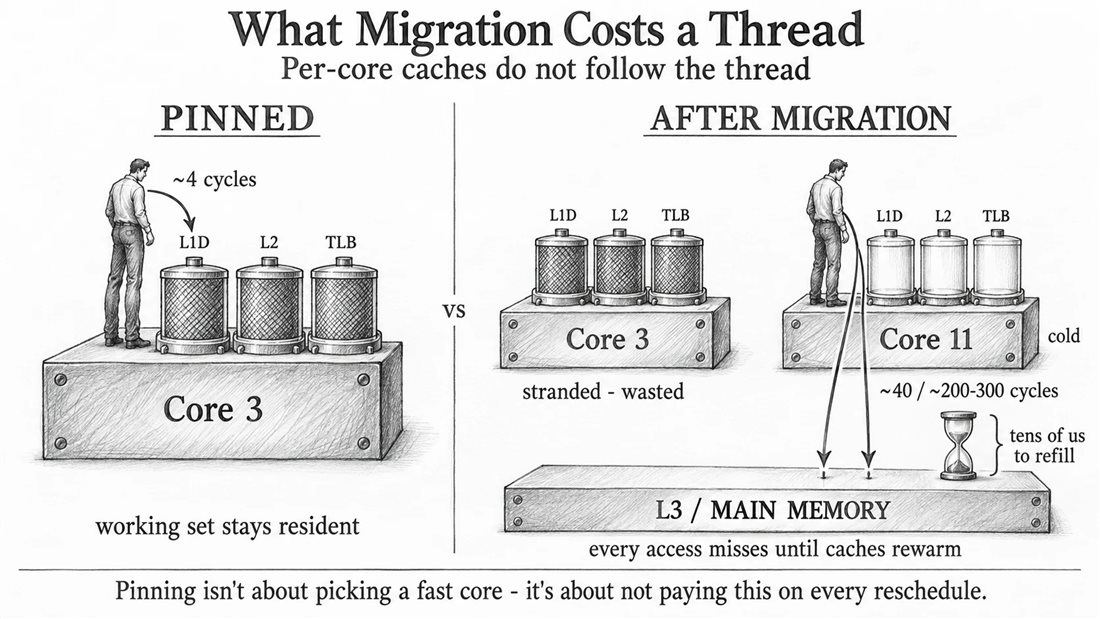
低延迟系统怕的是抖动,不是平均值。目标是让热线程成为它那个物理核上唯一在跑的东西:绑核消掉迁移,隔离参数把调度、时钟中断、RCU 和设备中断赶到打杂核,关超线程、禁深睡、锁频率去掉核自身的波动,最后让热线程只碰本节点的内存。
TTT 和 RTT 各量哪一段,为什么要报 p50、p99、p999 而不是平均值,在线程边界打点怎么看出时间花在处理还是排队,以及量级表怎么拿来做延迟预算。
TSC 读到的是什么、什么时候读到、在哪个核上读到,热路径上打点该怎么记,以及 tick 怎么换算成 ns:频率从哪来、怎么自己校准。
谁先跑、跑多久:调度类和时间片,实时优先级的三个坑,优先级反转的两种修法,PREEMPT_RT 为什么 HFT 常常不用,以及一台低延迟机器从 BIOS 到 sysctl 要动哪些开关。
从一把锁到多生产者:阻塞队列的条件变量和丢失唤醒,rte_ring 的两对下标和按顺序发布,Disruptor 的可用标记,以及队列满了该阻塞、丢弃还是覆盖。
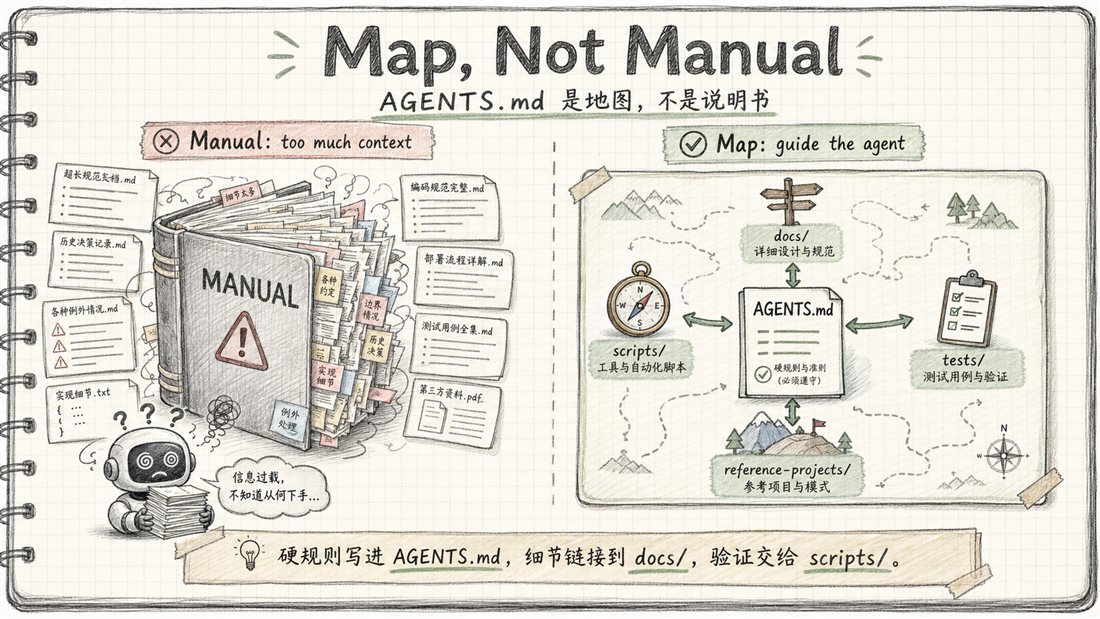
AGENTS.md is a README for AI agents: a compact project map that exposes hard rules, build/test commands, verification loops, and deeper documentation links so agents can understand, modify, and verify code without relying on …
Miller-Rabin primality test, Pollard Rho factorisation, Tonelli-Shanks for quadratic residues, cubic residues via F_p[t]/(t^3-a), quartic residues by double square root, and general k-th residues via primitive root + BSGS, plus …
Min_25 sieve: theory, two complete examples, Lagrange interpolation for power sums. Du Jiao sieve: template, P3768, GCD sum, LCM sum.
Greedy optimality for divisibility-chain coin systems, DP over the maximum denomination, and a sieve-style transition by adding one larger coin.
Eratosthenes sieve for μ; g/f/h framework; Conclusions 1 and 2 with derivations and tables; GCD table intuition; CF 803F Coprime Subsequences with bottom-up and Möbius approaches.
Multiplicative functions, single-point and linear-sieve evaluation; Möbius function, both forms of Möbius inversion with full derivations and examples; Dirichlet convolution, key identities, Du Jiao sieve; generalized Möbius …
Seven core techniques for Möbius inversion problems: loop shortening, gcd indicator expansion, coprimality reduction, Dirichlet convolution via T=dk, divisor symmetry, diagonal symmetry, and value-domain cnt[] tricks.
Practice problems for Möbius inversion: LCMSUM, two-variable lcm sum (O(n^3/4)), FSF’s game with offline difference, divisor-count sum d(ij), Omega Numbers with Dirichlet suffix sum.
Divisibility blocking for O(sqrt n) floor-sum evaluation: lemma, single-variable loop, O(1) interval sum requirements, two-variable min-trick, multi-variable pseudocode, and ceiling-division blocking.
GCD/LCM properties, Bézout/Frobenius, Euler’s theorem with power-tower reduction and φ-chain technique, congruence system merging via exGCD, CRT, and n! prime factorisation via Legendre’s formula.
Legendre’s formula, divisor and multiple convolutions in O(n log n), offline-difference batch processing for H(n)=Σf(d)g(⌊n/d⌋).
Hard matrix problems: Fibonacci squared subarray sum with segment-tree 4-tuple and companion matrix; cycle-decomposition partition state space for random-swap sorting, first-step analysis, and Gaussian elimination.
XOR linear basis: full template with kth, range basis, normalisation; Nowcoder median example; CF 1101G prefix-XOR rank; gym 104768 C XOR-divisibility; Simplex LP solver.
Gauss elimination: real/mod/mod-2 templates (solve, det, inv, rank); incremental online RREF; Extended Lights Out, CF 1344F abstract GF(2) modelling, 2024 ICPC Kunming interactive tree queries.
Matrix fast power for linear recurrences (4 patterns), 4 semiring templates (count/bool/min-plus/max-plus), matrix+segment tree for range-add Fibonacci queries, Kitamasa O(k²logn) and NTT O(k log²k logn).
Chromatic polynomial, chordal/interval graphs, PEO product formula, order polynomials (chain/antichain/tree/DAG/divisor lattice), MacMahon formula, Dilworth, Mirsky, Hall’s marriage theorem, Erdős–Szekeres, missile interception.
Newton iteration for polynomial inverse and square root, derivative/integral/composition of formal power series, logarithm and exponential of series, and worked examples including CF438E and a bad-modulus complete-knapsack …
Formal power series basics, ordinary generating functions, inversion identities, generalized binomial expansions, bounded counting examples, and recurrence-to-closed-form examples such as Fibonacci and Catalan.
Order and primitive roots (Euler’s theorem, BSGS, exBSGS), discrete index as logarithm analogue, SGU 261 Discrete Roots, NTT theory and templates, divide-and-conquer NTT (product tree), Wannafly D team selection, Nowcoder 50F …
Polynomial representations, FFT/DFT over complex numbers, Triple Sums, Fuzzy Search (difference convolution), FFT template, Lagrange interpolation (O(n²) and O(n) equidistant), sum of k-th powers, Assigning Prizes polynomial DP.
Cyclic convolution definition, FFT/NTT implementation for n=2^k, zero-padding, why n must be a power of two, and the fold-back technique for arbitrary n.
Cross-correlation via ordinary convolution: reverse-A and reverse-B extraction methods, derivation, and Ring Trick II (cyclic shift score maximisation via difference convolution).
Stars and bars, bounded Diophantine equations via inclusion-exclusion, prefix-sum DP, D&C NTT, equal-cap formula, and a full worked example on CF 2127F.
Hockey Stick identity, addition/multiplication principles, binomial identities, example problems: bitonic sequences, multiset permutations, multi-layer coloring DP, CCPC Subpermutation.
容斥原理的集合与算子形式、有上下界不定方程计数(前缀和DP与分治NTT)、错排公式与第二类斯特林数。
Inclusion-exclusion in set and operator form, equal-count subproblems, bounded Diophantine counting, derangements, Stirling numbers, and selected contest problems.
常见计数结论、Lucas 定理、不定方程解计数、平面分拆、DAG 路径计数、多项式平移、XOR 均匀性与若干竞赛常用结论。
A compact toolkit of geometric sums, floor-sum transformations, XOR facts, Fibonacci identities, and perfect-square patterns.
这个系列还没有文章。